用Stable Diffusion一键生成专属AI头像,告别撞脸


社交平台上,撞头像的尴尬时刻屡见不鲜。当你精心挑选或拍摄的头像,却被发现和某位好友甚至陌生网友一模一样,那种“撞脸”的失落感实在难以言表。幸运的是,随着AI绘画工具的爆发式发展,Stable Diffusion 为我们提供了一条全新的出路——只需输入几句话,就能瞬间生成一张独一无二、符合你想象的专属头像。
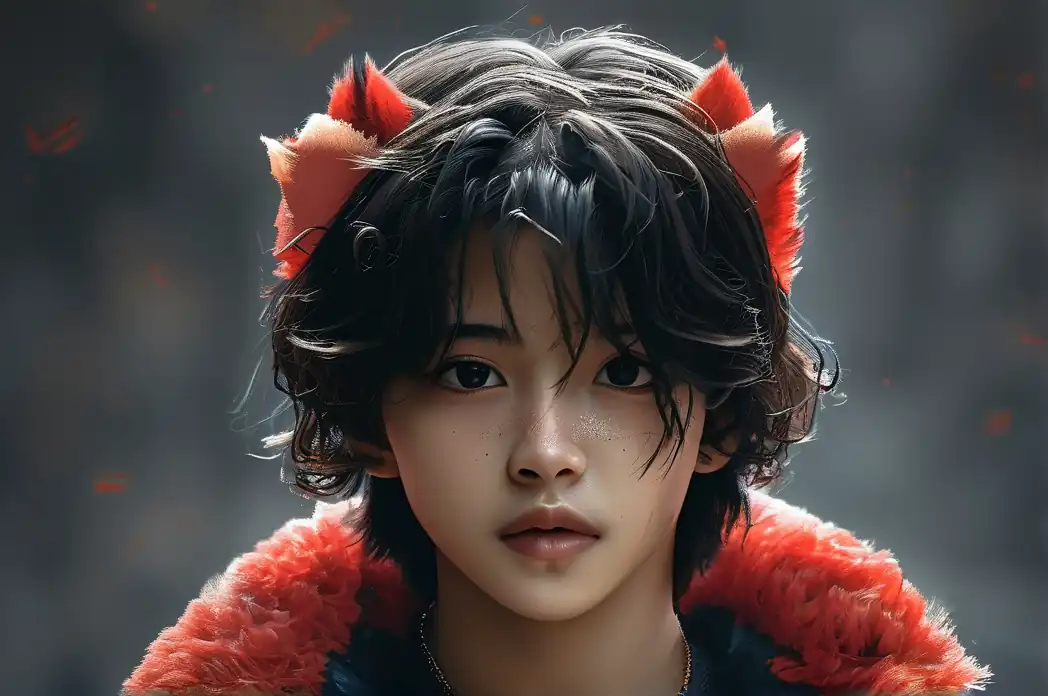
为什么选择Stable Diffusion做头像?
市面上有很多AI头像生成应用,但它们大多只能提供有限的模板或风格,且生成的图片往往带有明显的“AI味”。Stable Diffusion作为开源社区的核心AI工具,拥有无与伦比的灵活性和可定制性:
- 风格自由:从超写实照片到赛博朋克,从宫崎骏风格到像素风,只要你能想到,它就能生成。
- 极致个性化:通过修改提示词(Prompt)和负面提示词(Negative Prompt),你可以精准控制发型、表情、服装、背景等所有细节。
- 拒绝撞脸:每次生成都基于不同的随机种子,配合自定义参数,几乎不可能出现第二张一模一样的头像。
- 完全免费(自部署):如果你有显卡,可以本地运行Stable Diffusion WebUI,无限生成;无显卡用户也可使用在线平台。
准备工作:选择你的AI工具
要开始制作头像,首先需要选择一个运行Stable Diffusion的AI工具。这里推荐两种方式:
1. 本地部署(推荐)
安装 Automatic1111 WebUI 或 ComfyUI,这是目前最主流的Stable Diffusion图形界面。需要至少8GB显存的NVIDIA显卡,以及Python环境。对于新手,可以在B站或GitHub找到一键整合包。
2. 在线平台(零门槛)
没有显卡的用户可以选择:Hugging Face Spaces(搜索Stable Diffusion)、Replicate、Playground AI 等。部分平台有免费额度,足以生成数十张高质量头像。
本教程以 Automatic1111 WebUI 为例进行讲解,在线平台的参数设置逻辑完全一致。
第一步:选择适合头像的基础模型
模型是AI头像的“画风数据库”。不同的基础模型会产生截然不同的效果。推荐以下几款专为头像优化的模型:
- Realistic Vision V5.1:生成极其逼真的真人照片效果,皮肤细节和光影表现优秀,适合想要“看起来像真人”的头像。
- DreamShaper XL:兼顾写实与艺术感,支持多种风格,且对人物面部表情把控精准。
- MajicMix Realistic:专为写实人像优化,生成的五官精致,且不易出现畸形。
- 二次元风格:选择 Anything V5 或 Counterfeit V3,可生成动漫感头像。
如果你想要更独特的风格,可以搭配使用 LoRA(低秩适应模型)。例如,添加“赛博朋克风LoRA”、“水墨风LoRA”等,实现风格叠加。
第二步:编写精准的提示词
提示词是AI生成头像的核心指令。一个好的提示词应该包含:主体描述+细节特征+风格+环境。以下是一个写实头像的范例:
正面提示词:portrait of a young woman, long straight black hair, hazel eyes, fair skin, wearing a white turtleneck sweater, soft natural lighting, high resolution, hyperrealistic, detailed facial features, sharp focus, looking at camera, warm smile
负面提示词:ugly, deformed, blurry, low quality, bad anatomy, extra limbs, disfigured, mutation, watermark, text, logo, frame
如果你想要头像更有风格,可以在提示词中加入艺术流派,例如“studio ghibli style”、“digital painting”、“watercolor illustration”。
提示词技巧:
- 使用英文提示词效果更好,AI模型对英文理解最准确。
- 可以通过权重强化某些元素,例如
(highly detailed:1.2)。 - 想要改变背景?直接在提示词中写“plain background”、“city street”、“sunset beach”。
第三步:调节关键参数
在Stable Diffusion WebUI的生成界面中,以下参数对头像质量影响最大:
- Sampling method:推荐 Euler a 或 DPM++ 2M Karras,平衡速度与质量。
- Sampling steps:20-30步即可,过多步数不一定更好,还容易过拟合。
- CFG Scale:建议设置在7-10之间。值越高,AI越严格遵循提示词,但可能产生奇怪细节;值越低,自由发挥度越大。
- Width & Height:头像推荐512x512或768x768。如果想生成半身或全身,再调整比例。
- Seed:如果不满意当前结果,可以修改Seed值得到完全不同的构图和表情。
- Batch size:一次生成多张,方便筛选。
小贴士:如果生成的脸部细节有问题(比如眼睛不对称),可以启用 Face Restoration(面部修复)功能,选择 CodeFormer 或 GFPGAN 进行修复。
第四步:迭代优化与后处理
一张完美头像很少一次生成就能得到。你可以通过以下方式迭代:
- 换种子:将不满意结果的Seed值设为-1(随机),再次生成。
- 修改提示词:例如将“long black hair”改为“short curly blonde hair”来调整发型。
- 使用Img2Img:将生成的满意头像重新导入,用较低denoising strength(0.2~0.4)对细节进行微调。
- 后期裁剪与调色:用Photoshop或手机修图软件裁切到合适的头像尺寸,适当增加锐度。
如果在线平台生成了满意的图片,记得下载原图并保存种子编号,方便后续复刻或微调。
常见问题与解决方案
- 脸部扭曲或畸形:增加负面提示词中的“bad anatomy”、“extra limbs”,或降低CFG Scale到7以下。
- 风格不统一:确保基础模型和LoRA风格匹配,例如不要用写实模型配二次元LoRA。
- 背景杂乱:在提示词中加入“simple background”或“solid color background”。
- 生成速度慢:降低图片尺寸,或使用更快的采样器如LCM。
结语:你的专属头像即刻诞生
通过Stable Diffusion这个强大的AI工具,你完全可以摆脱千篇一律的头像库,创造出真正属于自己的视觉标识。无论是简约的职业照,还是充满幻想的奇幻肖像,你都能在几分钟内完成。记住,关键在于多尝试不同的提示词、模型和参数组合。现在就去打开你的Stable Diffusion WebUI,或者选择一个在线平台,开始第一次专属头像创作吧!
你与撞头的烦恼之间,只差一次生成的距离。

Sora 实操:三分钟 AI 生成电影级短片

ChatGPT 办公自动化:3 个实战技巧,让 AI 助手成为你的效率杠杆

用AI自动生成会议纪要,彻底告别无效加班

用AI自动化工具搭建文档中心,效率提升300%

Sora正式开放:AI生成视频实战指南

Sora落地指南:三分钟生成高质量短视频

告别加班:用 AI 重写周报,实现效率提升 300% 的实操指南

Midjourney 6 隐藏参数:让画面细节爆炸的 5 个技巧

从零构建 LLM Agent 记忆模块:架构设计与代码实战指南


